汎用 Vision LLM 9種を日本語OCRで全部試したら、Gemini 系が圧勝だった話
この記事でわかること
- 日本語 OCR + 構造化抽出に汎用 Vision LLM を使うとどうなるか の横比較
- Gemini 2.5 Flash / Flash Lite / 2.0 Flash Lite が精度も速度もコストも抜けていることの実データ
- Mistral Small・Nova Lite・Llama 4 あたりは縦書き日本文で壊滅的に弱いという意外な落とし穴
- GPT-5 nano のような reasoning モデルは出力 token を読解ではなく思考に使ってしまい、コスパ最悪
この記事でやらないこと
- Cloud Vision や Mistral OCR のようなOCR専用APIとの比較 は別テーマなので対象外
- 日本語以外の言語、手書き文字、表や図の抽出は今回スコープ外
⚠️ 今回の評価はあくまで「日本語OCR + 構造化抽出」という特定用途に限った話 です。英語OCR、コーディング支援、一般的な画像理解などでは、同じモデル同士でも順位がガラッと変わる可能性があります。ここでの結果は万能ランキングではなく、「この特定タスクではこう出た」という一枚スライスとして読んでいただけたらと。
検証セットアップ
全モデル OpenRouter 経由で叩きます
認証を一本化したかったので、全9モデルを OpenRouter 経由で呼び出しています。OpenAI/Google/AWS/Anthropic とバラバラにキーを管理するより、OPENROUTER_API_KEY 一本で済むので検証用途にはとてもありがたいです。料金もほぼパススルー (クレジット購入時に 5.5% 手数料が乗るだけ)。
対象モデル
| # | モデル | Input $/MTok | Output $/MTok |
|---|---|---|---|
| 1 | openai/gpt-5-nano | 0.050 | 0.400 |
| 2 | amazon/nova-lite-v1 | 0.060 | 0.240 |
| 3 | mistralai/mistral-small-3.2-24b-instruct | 0.075 | 0.200 |
| 4 | google/gemini-2.0-flash-lite-001 | 0.075 | 0.300 |
| 5 | qwen/qwen3-vl-8b-instruct | 0.080 | 0.500 |
| 6 | google/gemini-2.5-flash-lite | 0.100 | 0.400 |
| 7 | meta-llama/llama-4-maverick | 0.150 | 0.600 |
| 8 | qwen/qwen2.5-vl-72b-instruct | 0.250 | 0.750 |
| 9 | google/gemini-2.5-flash | 0.300 | 2.500 |
「コスト的に戦えるレンジ」だけを集めたつもりです。Claude Haiku 4.5 も候補にありましたが、Input $1 / Output $5 で上の9モデルより1桁高く、価格で勝負にならないと判断して除外しました。
テストデータ
全部合成画像です。HTML テンプレートにテキストを流し込んで Chrome headless で PNG 化する シンプルな仕組みで作っています。撮影の手間がかからず、何度でも同じ条件で再現できるのが強みです。実カメラ撮影特有のセンサーノイズなどは再現できませんが、そこは割り切りました。
- 一般文書 (document) — 青空文庫の著作権切れ作品 (吾輩は猫である、羅生門、走れメロスなど) を縦書き本ページ風にレンダリング。10種類
- 問題集 (exam) — 現代文・古典・社会・数学・理科・英語・地理の模試風ページ。8種類
- レシート (receipt) — コンビニ・スーパー・ドラッグストア・飲食店・書店・調剤薬局など。12種類
イメージが湧きやすいように、実際にモデルに投げた画像の例を載せておきます。
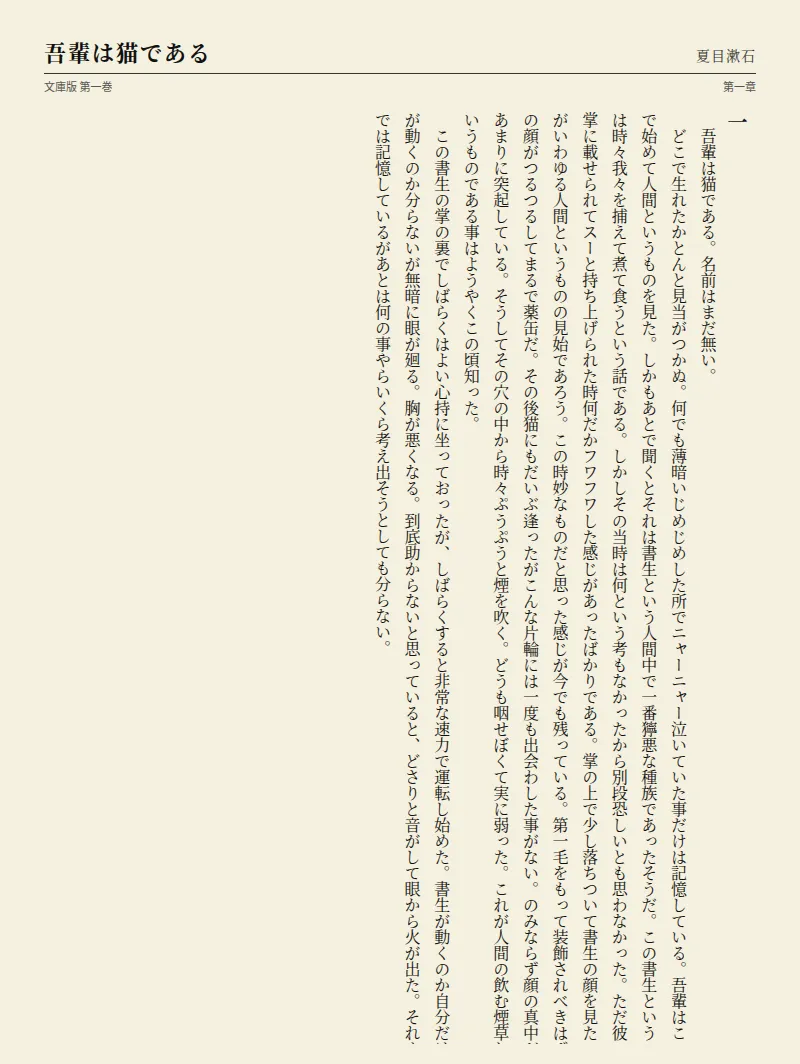
こんな感じの画像を 192 枚、各モデルに投げました。縦書きの日本文を左から右への横書きとして読んでしまう問題が、今回の結果に強く出ました。
バリエーション
各原本に対して以下の加工バリエーションを適用して、合計 192 枚 の画像を作りました。
- A. Clean — 基準
- B. Low-res + Blur — 長辺 45% リサイズ + Gaussian blur
- C. Rotation — ±4〜±12度 のランダム回転
- D. Noise — 背景にペーパーテクスチャ重畳 + ピクセルノイズ
- E. Shadow — 斜め方向のグラデーション影
- F. Fold — 折り目 (レシートのみ)
- G. Crop — 端 10〜18% をトリミング
画像サイズ
実運用で API コストを抑えるために画像を圧縮して送る前提に合わせて、送信前に長辺 768px にリサイズ しています。これは「高解像度で送りたいけどトークン料金が気になる」ときに現実的に選ぶ圧縮レベルです。
プロンプト
カテゴリ別に JSON 形式の出力を指定しています。document は {title, body, notes}、exam は {lead, questions, notes}、receipt は {store_name, date, items, subtotal, tax, total, notes}。各モデル固有の JSON モードは使わず、プロンプトだけで指示しました (公平性のため)。
呼び出し設定
- temperature: 0
- max_tokens: 8192
- 並行度: プロバイダあたり10
9モデル × 192画像 = 1,728 回の API 呼び出し を約 41 分、総コスト $1.18 (約180円) で走らせました。
総合ランキング
| 順位 | モデル | 精度 (平均) | コスト (1,728呼び出し合計) | レイテンシ中央値 |
|---|---|---|---|---|
| 🥇 | gemini-2.5-flash | 0.878 | $0.267 | 2,913 ms |
| 🥈 | gemini-2.5-flash-lite | 0.856 | $0.057 | 2,727 ms |
| 🥉 | gemini-2.0-flash-lite | 0.817 | $0.041 | 3,295 ms |
| 4 | qwen2.5-vl-72b | 0.718 | $0.140 | 19,659 ms |
| 5 | llama-4-maverick | 0.543 | $0.141 | 17,880 ms |
| 6 | qwen3-vl-8b | 0.461 | $0.078 | 22,555 ms |
| 7 | gpt-5-nano | 0.407 | $0.282 | 29,153 ms |
| 8 | mistral-small-3.2 | 0.285 | $0.061 | 17,817 ms |
| 9 | nova-lite | 0.128 | $0.112 | 12,554 ms |
精度は 1 から文字誤り率 (CER) や構造フィールド F1 を引いたもので、カテゴリごとに定義しています (後述)。
コスト vs 精度
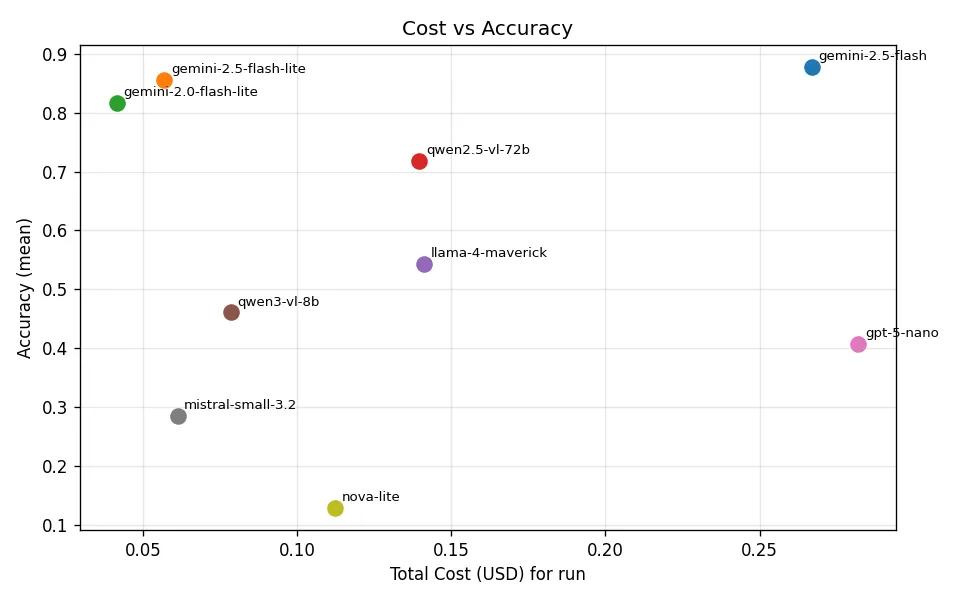
左上 (安くて精度高い) が良いゾーンです。Gemini 3兄弟が左上に固まっていて、そこから急に落ちていきます。特に gemini-2.0-flash-lite は 1,728回の呼び出しで $0.04、精度 0.82 という暴力的なコスパです。
GPT-5 nano は価格表上は安い方なのに、実測では Gemini-2.5-flash と同じくらい高くつきました。reasoning tokens を出力に計上するので、実質単価が上がるんですね。
カテゴリ別精度 (ヒートマップ)
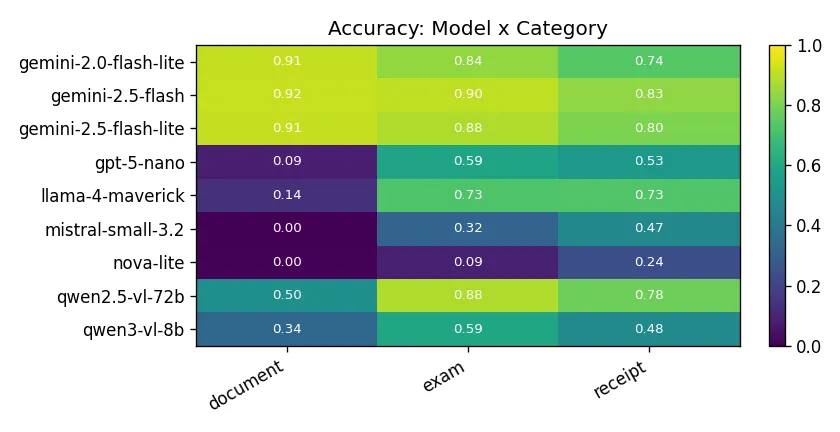
このグラフを見ると、「縦書きの日本文書 (document) に対応できているモデル」と「できていないモデル」の二極化がはっきりわかりますね。横書きのレシートや問題集では差が小さいのに、document のカラムだけ極端な明暗が出ています。
縦書き日本文書 (document) で大事故
- mistral-small-3.2: 0.00
- nova-lite: 0.00
- llama-4-maverick: 0.14
- gpt-5-nano: 0.09
縦書き・漢字混じり・多段組みの日本語本を投げると、このあたりのモデルは苦戦していました。中身を見ると、縦書きを右から左に読み進める挙動が弱く、順序が前後したり、内容の把握が難しそうな様子です。
一方で Gemini 系は 0.91-0.92。このカテゴリは本当に得意そうです。
念のため繰り返しておくと、これは日本語縦書き文書というかなり限定的な条件での話です。Mistral や Nova、Llama も横書き英語や他タスクでは違った評価になるはずなので、「このモデルはダメ」と一般化するのは禁物です。
問題集 (exam) は中〜高精度
構造化された選択肢とリード文があるので、どのモデルも比較的読みやすいカテゴリです。Gemini、Qwen2.5-VL-72B がトップ群。Mistral と Nova はここでも低めですが、documentほどの悲惨さはないです。
レシート (receipt) は底上げされる
横書き・短文・等幅系フォントなので、縦書きが苦手なモデルでもそれなりに読めます。ただし金額や税区分の数値を正確に取る必要があるので、雑なモデルだと items のフィールドF1 が下がります。
トークン使用量の裏側
価格表は input $/MTok と output $/MTok しか載っていないので、実際に1画像あたり何 token 飛ぶのか を計測しないと実コストが読めません。1,728回の呼び出しの実測値がこちらです。
| モデル | 入力tok平均 | 出力tok平均 | 出力tok p95 | JSON成功率 | レイテンシp95 |
|---|---|---|---|---|---|
| gemini-2.5-flash | 1,375 | 391 | 579 | 98.4% | 3.9秒 |
| gemini-2.5-flash-lite | 1,377 | 395 | 574 | 100.0% | 4.0秒 |
| gemini-2.0-flash-lite | 1,377 | 374 | 549 | 99.0% | 4.4秒 |
| qwen2.5-vl-72b | 776 | 711 | 589 | 94.8% | 19.8秒 |
| llama-4-maverick | 1,103 | 950 | 8,192 | 93.2% | 70.5秒 |
| qwen3-vl-8b | 697 | 705 | 1,396 | 86.5% | 33.6秒 |
| gpt-5-nano | 884 | 3,562 | 7,194 | 96.4% | 48.2秒 |
| mistral-small-3.2 | 848 | 1,274 | 8,192 | 55.7% | 67.9秒 |
| nova-lite | 1,480 | 2,065 | 5,120 | 63.0% | 30.2秒 |
読みどころ:
- Gemini 3兄弟はすべて安定。出力平均 400 token 前後で、p95 でも 600 token に収まります。プロンプトを「JSONだけ返せ」と書くと、本当にきっちり JSONだけ返してきます。JSON成功率も 98〜100%。
- Llama 4 Maverick と Mistral Small 3.2 は p95 = 8192 に張り付いています。これは
max_tokens上限なので、「途中で打ち切られた出力」が相当数あることを示しています。JSON 解析が失敗する原因もここ。 - GPT-5 nano の出力平均 3,562 token は他モデルの約10倍。reasoning token を出力に積んでいるためで、reasoning モデルを OCR タスクに使うことのコスト的な副作用がくっきり見えました。
- Mistral Small 3.2 の JSON 成功率 55.7% は記事作成時に2回見直したくらい低かったです。約半数の回答が JSON として解析できない文字列を返してきています。
- Nova Lite は出力 p95 = 5,120 token。本文中にJSON と自然文が混ざったり、同じキーが何度も繰り返されたりする「JSON 崩壊」が多く見られました。
1画像あたりの実コスト計算
Gemini 2.5 Flash Lite を例に実測値で計算すると:
- Input: 1,377 tok × $0.100/MTok = $0.000138
- Output: 395 tok × $0.400/MTok = $0.000158
- 1画像あたり約 $0.000296 ≒ 0.045円
同じ計算を他モデルでやると:
| モデル | 1画像あたりコスト |
|---|---|
| gemini-2.0-flash-lite | $0.000215 (約 0.032円) |
| gemini-2.5-flash-lite | $0.000296 (約 0.045円) |
| mistral-small-3.2 | $0.000319 (約 0.048円) |
| qwen3-vl-8b | $0.000409 (約 0.061円) |
| nova-lite | $0.000584 (約 0.088円) |
| qwen2.5-vl-72b | $0.000728 (約 0.109円) |
| llama-4-maverick | $0.000736 (約 0.110円) |
| gemini-2.5-flash | $0.001390 (約 0.208円) |
| gpt-5-nano | $0.001470 (約 0.220円) |
Gemini 2.0 Flash Lite は 1枚 3銭 です。年間 36万枚流しても 1万円ちょいで終わる世界です。
価格の安さだけでは判断できないこと
価格表だけ見ると Mistral Small 3.2 は 1画像 $0.000319 とかなり安いのですが、JSON成功率が 55.7%。半分は再試行する羽目になるので、実効コストは約2倍です。加えて縦書き日本文の精度は 0.00、問題集 0.32、レシート 0.47 と、今回のタスクでは数字が伸びませんでした。
「価格 × 成功率 × 精度」で見ないとモデルの実効的な安さは見えてこない、という教訓になりました。Mistral Small 自体は英文や他タスクでは評価が違う可能性があるので、あくまで今回の検証条件下での話として読んでください。
個別モデルの所感
Gemini 2.5 Flash / Flash Lite / 2.0 Flash Lite
どれを選んでも外さない安心感があります。
- 2.0 Flash Lite ($0.04) — とにかく安く雑に使いたいとき。精度も 0.82 で十分実用レベル
- 2.5 Flash Lite ($0.06) — 日常使い推奨。コスパ良すぎ
- 2.5 Flash ($0.27) — 最高精度が欲しい本番用途
Qwen2.5-VL-72B
document でも 0.50 を出してきて善戦。ただしレイテンシが中央値 20 秒と遅め。大量バッチ処理には向きません。
Llama 4 Maverick, Qwen3 VL 8B
横書き系はそこそこ (0.7 程度) で実用圏内ですが、縦書きは苦手でした。速度も Gemini に比べると遅めです。今回の日本語OCR用途では Gemini に譲る形ですが、OSS 系・他言語・他タスクで評価される場面も多いモデルなので、用途しだいで印象は変わりそうです。
GPT-5 nano
reasoning モデルなので出力前に大量の思考 token を消費します。出力 max_tokens を 4,096 にしていた当初は本文が出てくる前に打ち切られて response が空になるケースも出ました。8,192 に増やして再走したら改善しましたが、コストはその分増えます。画像を読んで転記するだけのタスクに reasoning 系は オーバースペックかもしれません。思考力を活かす別のタスクでは本領を発揮しそうです。
Mistral Small 3.2
output $0.20/MTok という破格の安さで期待していたのですが、今回の日本語縦書きタスク では精度と JSON 成功率の両方で苦戦しました。英文や横書き中心のタスクでは評価が変わる可能性があるので、用途に合うか個別に試すのが良さそうです。
Nova Lite
今回の数字としては最下位となりました。input $0.06 はとても魅力的なので、日本語縦書きを扱わない用途 (英語OCR、短い横書きテキスト、他のマルチモーダルタスクなど) では選択肢として残ると思います。
結論 (今回の日本語OCRタスクに限った話として)
- 日本語 OCR で安価に回したいなら Gemini 2.0 Flash Lite か 2.5 Flash Lite が第一候補に置けそうです
- 最高精度が欲しいなら 2.5 Flash、それでも 1,728 回の呼び出しで $0.27 なので予算面のハードルは低いです
- Mistral、Nova、Llama、GPT-5 nano は、日本語縦書きを含むタスクで選ぶ場合は価格表だけでなく実測で確認したほうが安全。別のタスクや言語では違う評価になる可能性が十分あります
- OSS 寄りで選ぶなら Qwen 2.5 VL 72B が健闘しています。レイテンシが長いのでバッチ処理向き
レイテンシの内訳
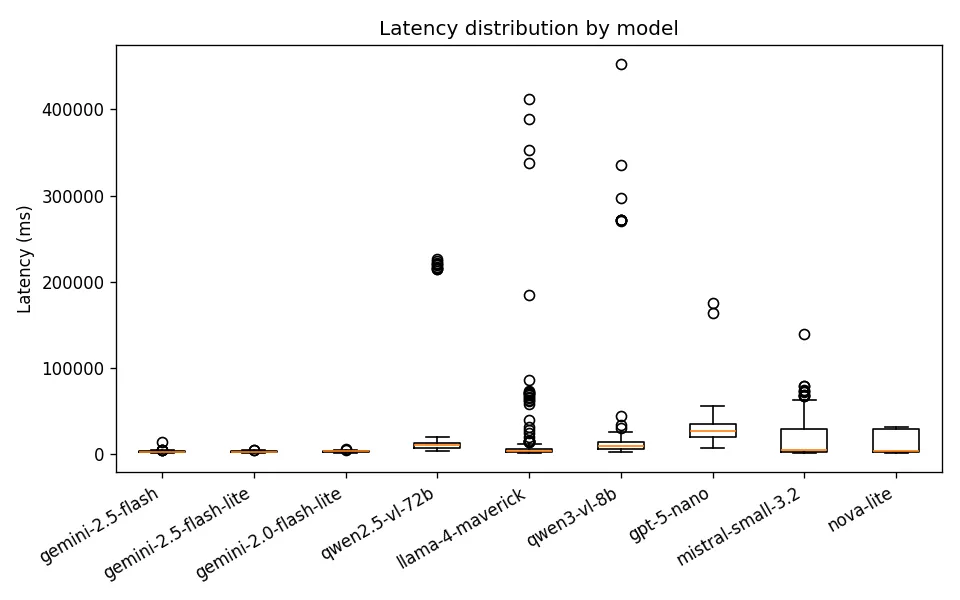
外れ値を見ると、mistral-small-3.2 と llama-4-maverick は最悪ケースで 1分以上 かかっています。これは出力が max_tokens=8192 に張り付くケースで、JSON の閉じ括弧が出てこず延々とテキストを垂れ流している状態でした。
Gemini 系は p95 でも 4 秒以内に収まっていて、バッチ処理のタイムアウト設計が圧倒的にやりやすいです。
シリーズ化するかもしれません
新しいモデルが出たら configs/models.yaml に1ブロック追加するだけで再ベンチできる構成にしてあります。気になるモデルが増えてきたら、同じテストデータで追加計測して続編を書くかもしれません。
免責
- 本記事は「日本語OCR + 構造化抽出」という特定タスクの結果 です。英語OCR、手書き、コーディング、画像理解など別の用途では、同じモデルでも順位はかなり動くはずです
- モデルの精度はアップデートで変わります。本記事の値は 2026-04-19 時点のスナップショットです
- 評価は合成画像ベースなので、実カメラ撮影の画像では結果が変わる可能性があります
- JSON 出力が取れた前提で構造化評価をしているので、JSON 成功率が低いモデルは実質もっと低精度と考えるべきです
- 各モデルは OpenRouter 経由で呼び出しており、プロバイダ直契約の場合は挙動・料金が微妙に変わる可能性があります